

- 打开微信,搜索「软件教程管家」关注,或长按下方二维码关注
- 回复关键词 Rainman Translate Book (提取码
qjku) - 公众号自动回复网盘链接,点击即可保存下载
 打开微信扫一扫关注
或搜索【软件教程管家】
Rainman Translate Book 是开发者 deusyu 写的一个开源 AI 翻译 Skill,以 MIT 协议发布在 GitHub,专门给 Codex、Claude Code、OpenClaw 这三类 Agent 宿主使用。它不是自己调模型的独立软件,而是一套跑在你本地 Agent 里的 skill:丢进一本 PDF、DOCX 或 EPUB,由 Agent 派出多个并行 subagent 把整本书翻成任意语言,最后用 Calibre 和 Pandoc 合并回带浮动目录的 EPUB、PDF 或 DOCX。
作为一个开源软件和开源项目,它受 claude_translater 启发但独立实现而非 fork,本身不调用任何模型 API,翻译算力来自你自己已经在用的大语言模型订阅。
场景痛点
手里有一本几百页的英文技术书或学术专著,想翻成中文 EPUB 放阅读器里慢慢看。直接把 PDF 整份喂给 ChatGPT 或 Claude,单次上下文窗口装不下,长文翻到一半就截断;分章节手动贴,前后术语译名又对不上,人物、机构和公式符号一章一个译法。装一个传统翻译 SaaS 又要注册账号、按字数付费,还要把整本书上传到别人服务器,对想自己握 API Key、又不想把书传到陌生平台的人并不友好。
主要功能特点
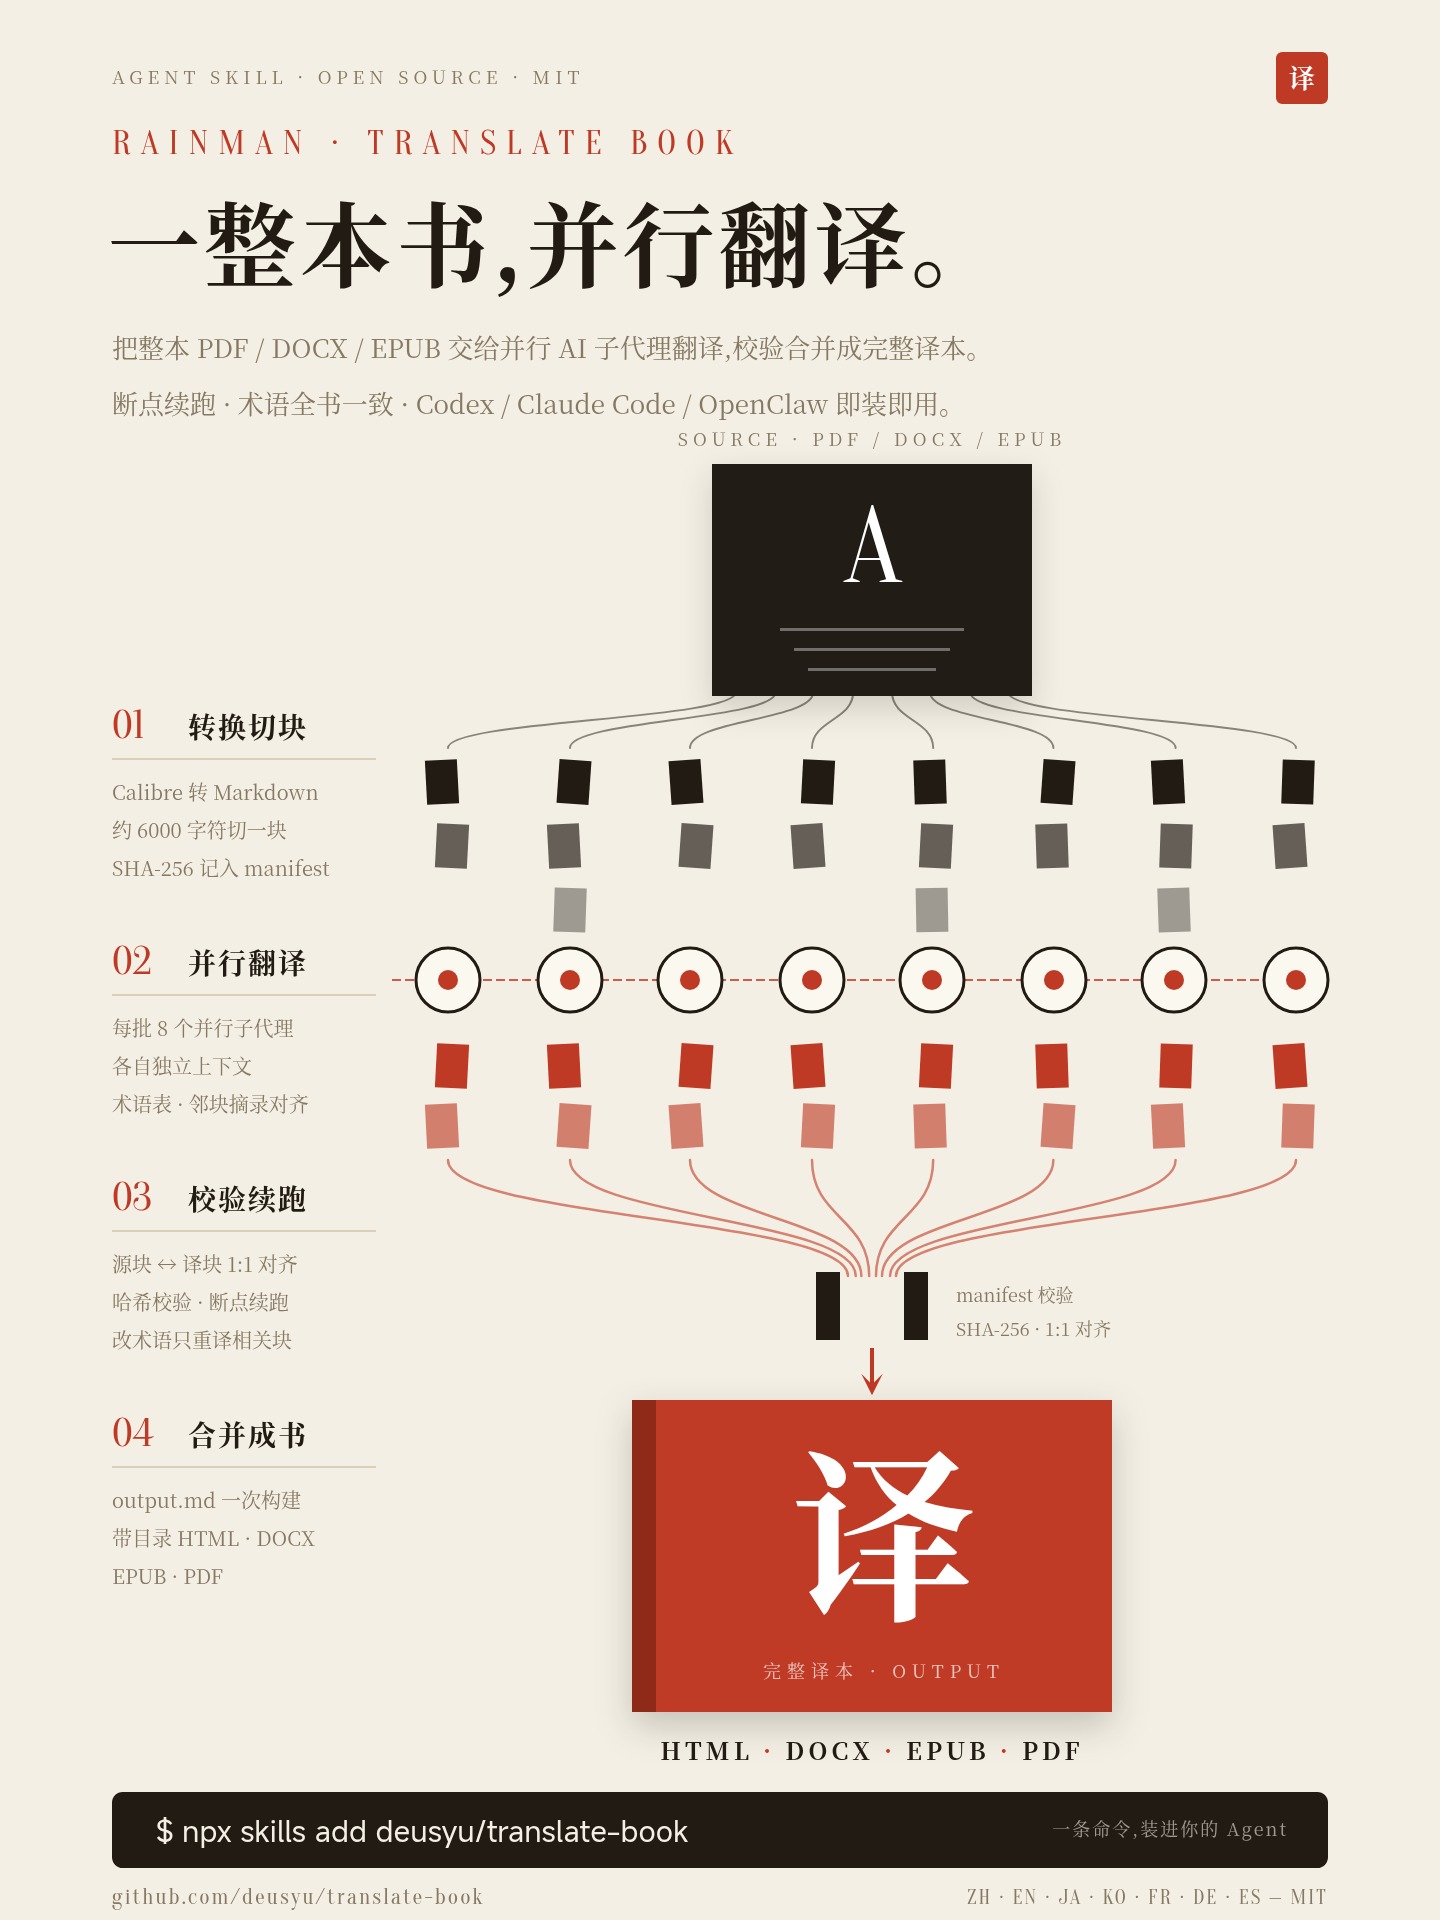
- 并行 subagent — 每批 8 个并发翻译器,各自独立上下文
- 可续跑 + 精确重译 — chunk 级续跑,并用
run_state.json追踪受术语表影响的重译范围 - 邻居上下文 — 每个 chunk 可读取相邻 chunk 的短只读摘录,用于代词和实体判断
- Manifest 校验 — SHA-256 hash 追踪,防止过时或损坏的输出被合并
- 多格式输出 — HTML(含浮动目录)、DOCX、EPUB、PDF
- 可选输出控制 — 显式 EPUB 封面、自定义 temp root、面向用户的导出别名
- 多语言 — zh、en、ja、ko、fr、de、es(可扩展)
- 多格式输入 — PDF/DOCX/EPUB/Markdown,Calibre 负责格式转换;公式、表格密集的 PDF 可先用 MinerU 或 Marker 转成 Markdown
八路并行 subagent 翻译
整本书先由 Calibre ebook-convert 转 Markdown,按 6000 字符切 chunk。默认派 8 个并行 subagent,每个只读一个 chunk、写 output 文件,独立上下文。目标语言覆盖中英日韩法德西,绕开单次会话翻整本书的上下文堆积。作为开发者工具与效率工具,它把整本书拆成 N 个小任务。
Chunk 级续跑与精确重译
run_state.json 记录每个 chunk 的术语表状态,manifest.json 算 SHA-256 哈希,source_fingerprint.json 把 temp 目录和源文件字节绑死。中断重跑,合法输出的 chunk 跳过;术语表改了,只重译受影响的 chunk。源文件被替换再跑会报错中止,避免旧译文合到新书。
邻居上下文与一致性校验
每个翻译 subagent 动手前,可读相邻前后 chunk 各约 300 字的短只读摘录,用来判断代词指代和跨章节实体关系,避免孤立翻译把 he、she 或机构简称译错。合并前跑 hash 比对、源 chunk 与输出 1:1 配对、非空非空白检查,脚注标记原样保留。这是典型的软件工具思路:先校验再合并。
术语表 v2 统一全书译名
翻译前,它从首章、末章和三个中间章抽 5 个 chunk 抽术语,成 glossary.json。每个 chunk 翻译时,注入「原文|别名|译文」三列表作硬约束。提供 count-frequencies、print-terms-for-chunk 命令,v1 自动升级 v2。这也是它区别于随手贴上下文那种 AI 工具做法。
多格式输入与 EPUB 成品
输入接受 PDF、DOCX、EPUB,也可直接吃 Markdown,如 MinerU 或 Marker 产物。公式表格密集的 PDF 建议先经 MinerU 或 Marker 转 Markdown,公式和表格保留,Pandoc 出 HTML/PDF 时渲染成 MathML。最终出带浮动目录的 book.html 以及 docx、epub,对用电子书阅读器的人顺手。
页码清理与轻量前置依赖
PDF 输入自动识别并删掉单调递增的页码序列,但保留 1984 这类年份、章节编号和引用编号;EPUB 和 DOCX 默认保留独立数字行,页码本来就不是正文。前置:Agent 环境、Calibre、Pandoc、Python 3 加 pypandoc。维护者优先提 issue 而非 PR,也不接受第三方模型中转站配置教程。
项目地址
GitHub:deusyu/translate-book
下载区
获取下载链接:微信关注公众号「软件教程管家」,回复【Rainman Translate Book】自动获取网盘链接。
关注「软件教程管家」
回复软件名即取即下:网盘下载链接 + 提取码,一步直达,不用再跳转。
本站资源仅供个人学习交流,请勿用于商业用途。软件与资料版权归原作者所有;如有侵权,请通过公众号「软件教程管家」联系我们,我们将在 24 小时内下架处理。查看免责声明 ›
文章推荐
标签推荐



这款软件怎么样?
平均 暂无评分(0 人评)
取链次数:0
评分与投票来自真实访客,从 0 开始累计;觉得有用就点一下,帮更多人判断这款软件值不值得下。